KI-Modelle im Kundenservice: Benchmark-Gewinner vs. Praxis-Realität
20 Modelle, 12 reale Kundenservice-Aufgaben, 2.400 Datenpunkte — und Tests, die den Modellbetreibern vorab nicht bekannt sind. Was auf dem Prüfstand glänzt, fällt im Alltag oft durch.
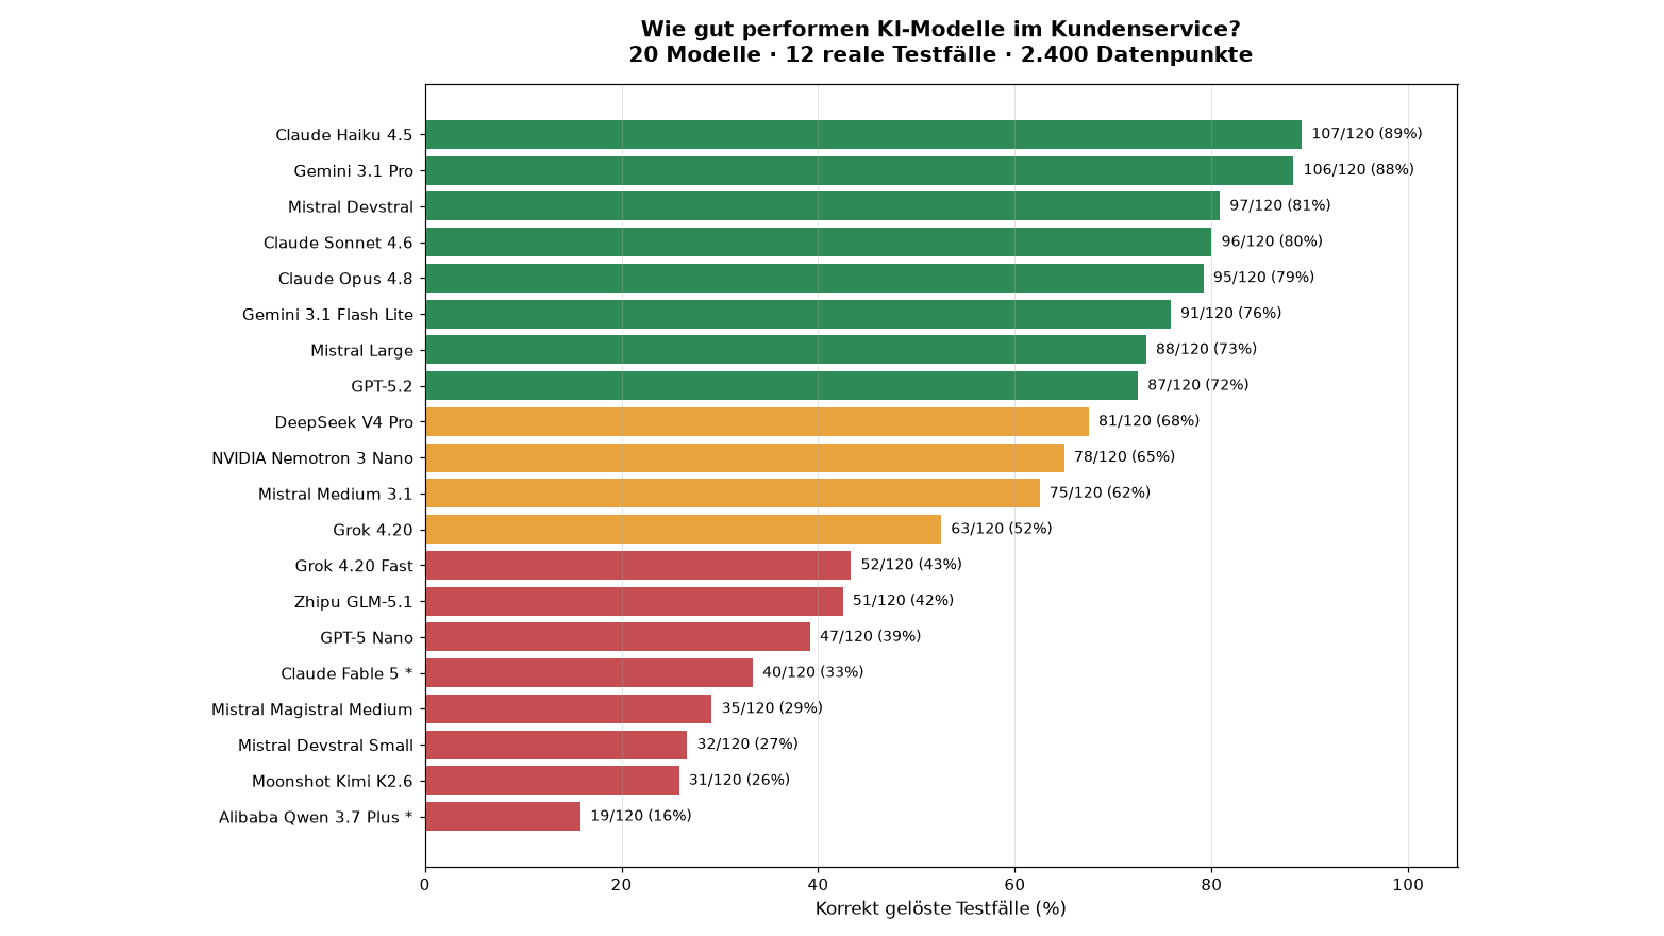
Das aktuelle Update unseres regelmäßigen Modell-Benchmarks ist da. Diesmal mit dabei: sechs brandneue Modelle, darunter Anthropics neues Spitzenmodell Claude Fable 5, das wir direkt nach Veröffentlichung messen konnten.
Warum wir nicht mit synthetischen Benchmarks testen
Wir testen führende KI-Modelle nicht mit synthetischen Benchmarks, sondern mit zwölf realen Kundenservice-Aufgaben — Tarifberatung, Klassifizierung, Backend-Interaktion und anderen. Entscheidend ist dabei, dass diese Tests den Modellbetreibern vorab nicht bekannt sind. Genau das macht den Unterschied zu LLMArena und vergleichbaren Ranglisten: Was auf dem Prüfstand glänzt, fällt im Alltag oft durch.
Die Ergebnisse im Einzelnen
Aus 2.400 Datenpunkten über 20 Modelle:
- Intelligenz allein reicht nicht. Claude Fable 5 lässt sich nicht mehr vorschreiben, was es zu tun hat — in diesem Fall, ein bestimmtes Tool aufzurufen. Genau das ist im Kundenservice aber oft zwingend nötig und zählt im Test als Fehler. Daher landet das stärkste Modell nur auf Rang 16. Eine interessante Parallele zum Menschen: Je intelligenter jemand ist, desto schwerer ist er zu kontrollieren.
- Oft reichen einfache Modelle, die das Problem nicht überdenken. Claude Haiku 4.5 erreicht 89 Prozent und schlägt seine großen, deutlich teureren Geschwister Sonnet (Rang 4) und Opus (Rang 5) — nicht bei den komplexen Aufgaben, aber im Durchschnitt über den ganzen Testparcours. Im Kundenservice braucht es nicht das teuerste Modell, sondern das zuverlässigste.
- Google holt auf. Gemini 3.1 Pro springt auf Rang 2 mit 88 Prozent, und Gemini 3.1 Flash Lite ist das schnellste Modell im Test mit unter zwei Sekunden bei gleichzeitig starker Qualität. Schnell und gut schließt sich nicht aus.
- Europa steht auf dem Podium. Mistrals Devstral belegt Rang 3 — vor Sonnet, vor Opus, vor GPT-5.2. Mit Mistral Large und Medium stehen gleich drei EU-Modelle im oberen Feld. In globalen Rankings sind sie kaum sichtbar, bei uns vorn.
- Große chinesische Modelle glänzen in Benchmarks. In der Praxis bleiben sie deutlich schwächer: GLM-5.1 (Rang 14) und Kimi K2.6 (Rang 19) liefern nur einen Bruchteil ihrer Benchmark-Werte. DeepSeek V4 bleibt das stärkste chinesische Modell, aber auch nur im Mittelfeld.